做了十几年 Unity 客户端,我见过太多性能优化做成”哪里卡补哪里”的补丁工程。这篇把移动端性能问题按四层摊开——渲染、CPU 逻辑、内存、加载与包体,每层讲清瓶颈成因和排查入口。读完你该获得的不是一堆参数,而是一张先定位、再动手的瓶颈地图。
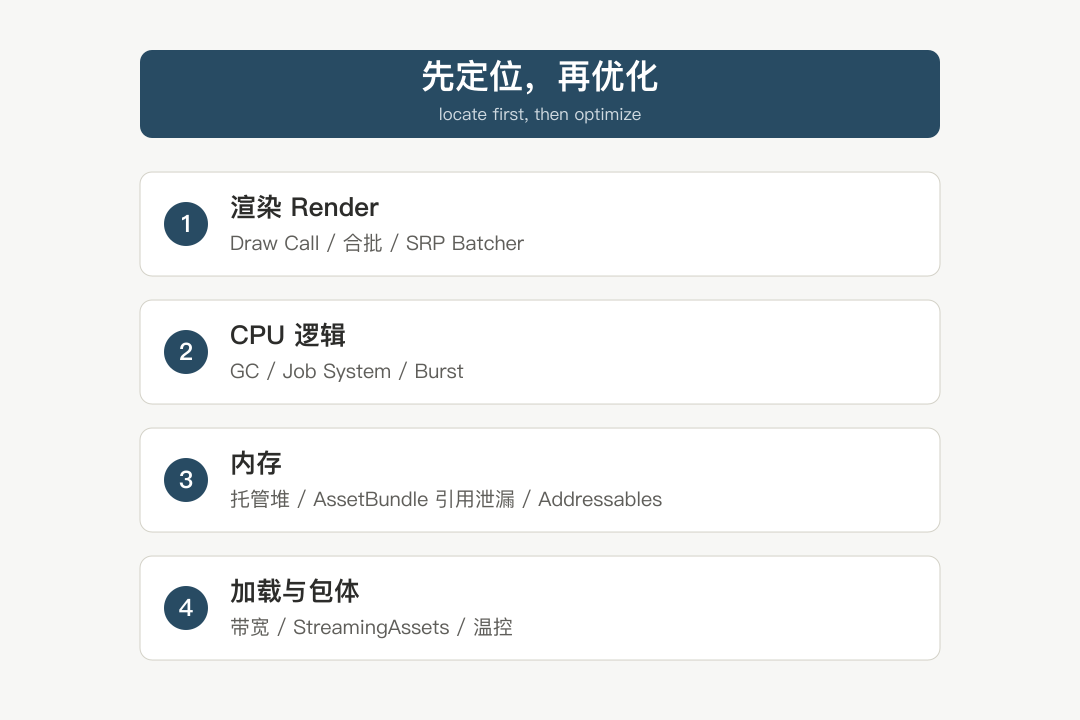
总纲:先定位,再优化
统一内存架构下,CPU、GPU、带宽、内存任何一处都可能成为瓶颈,而且瓶颈会漂移——你把 Draw Call 压下去,下一帧卡的可能变成 GC。所以优化的第一步永远是打开 Profiler 和 Frame Debugger 看清当前瓶颈在哪一层,而不是凭直觉改代码。
一个老但好用的经验公式:移动端 CPU 每秒大约消化 25K 次绘制命令(按 1GHz 折算)。目标 30 帧的项目,Draw Call 预算就是 800 上下;中低端机再打个对折。先算预算,再对着预算裁,比”尽量减少”这种模糊目标有效得多。
还有一个工程直觉必须先立住:美术规范靠口头约定是无效的。纹理必须压缩格式真机验证、基准机型按跑分档位预留空间、性能测试禁止用”同一资源复制 N 份”(合批数据会失真)——这些必须做成 Editor 菜单里的强制校验,卡在提交环节,而不是写在 Wiki 里等人自觉。
第一层:渲染——Draw Call、合批与 SRP Batcher
这一层的目标是让 CPU 的绘制命令恰好被 GPU 消化,互不等待。传统手段是 Draw Call 合批:静态合批、动态合批、GPU Instancing,共同前提是材质共享、shader 兼容。2019 年之后,SRP Batcher 接管了大半合批逻辑——只要材质走 CBUFFER,同 shader 的物体可以跨网格合批,这直接改变了很多老项目的优化收益结构。
老项目迁 URP 时先量 SRP Batcher 的收益再动手,而不是先改造材质。我见过团队花一个月改了几百个 shader 迁 URP,结果 Frame Debugger 里省下的 SetPass Call 不及预期的一半——因为原瓶颈根本不在渲染线程。
GPU 侧的三个老原则至今不变:减顶点(LOD、遮挡剔除)、减 overdraw(不透明从前向后、UI 少用大面积透明设计)、简化 shader(查表代复杂运算、低精度浮点、移动端慎用 alpha_test)。另外视野外的粒子仍在 Update 是个高频暗坑,用 OnBecameVisible / OnBecameInvisible 整组启停,配合缩小的 MeshRenderer 容器,一行代码的事,能救回整片粒子系统的开销。
第二层:CPU 逻辑——GC、Job System 与 Burst
这一层的头号敌人是托管堆分配。Update 循环里的每一次临时分配都在给 GC 攒账单,Mono 时代的增量式 GC 还没普及到所有项目,一次 Full GC 在低端机上就是一次可感知的掉帧。治理手段按性价比排序:缓存一切引用(GetComponent 和手动缓存的耗时差两个数量级)、高频路径 for 代 foreach、字符串用 StringBuilder、慎用 LINQ、热路径不打日志不查组件、对象池管住高频创建销毁。
// Update 高频路径的反面教材与正解
void Update() {
    // 反面:每次访问都穿透一次组件查找,且 string 拼接产生 GC 分配
    // label.text = "HP: " + player.GetComponent<Health>().cur;

    // 正解:引用缓存 + 隔帧 + 整数拼接
    if ((Time.frameCount & 3) != 0) return;
    label.text = $"HP: {hp.cur}";
}
复杂运算上两条路:轻量级直接隔 N 帧分摊,让开销从”每帧”变”每几帧一次”;真正吃 CPU 的(寻路、AI 决策、大量单位运动)交给 Job System + Burst。Unity 5 时代”移动端避免多线程”的告诫已被 Job System 打破——它是安全的、结构化的多线程,配合 Burst 编译常有十倍级收益。
但有个反建议:Job System 不是免费的。数据要搬进 NativeContainer、调试器支持弱、团队要理解 Job 依赖关系。几百个单位的移动逻辑值得上 Job,几十个单位的日常逻辑硬套 Job 只是给维护者找麻烦。先用 Profiler 确认 Bottleneck 面积足够大,再上这套重武器。
顺带讲一段历史,帮你看懂老代码里的”谜之操作”。Mono 时代还有一类卡顿源头是 JIT 首编译:同一个函数首次调用远慢于后续,新地图新玩法上线那几帧特别卡就是它。当时最工程化的解法是改 Mono 源码在 mono_compile_method 插桩圈定热点区间,只对命中的百来个类型预热——全量预热要加 8 秒启动,不可行。后来 IL2CPP 全量 AOT 编译,这个问题整体消失。有意思的是,HybridCLR(解释执行热更程序集)又以”AOT 泛型补充元数据”的形式把预热议题带了回来——同一类问题在运行时换代后会换一张脸重新出现,认得出来比记得解法更重要。
如果项目还有 Lua 脚本层(tolua/xlua 时代的遗产),这一层还要叠加 LuaJIT 的规则:不可预测的分支破坏 trace 编译、热路径函数要 local 缓存、避免 NYI 操作。详见热更篇。
第三层:内存——托管堆、AB 引用泄漏与 Addressables
Unity 是双内存模型:Mono 托管堆归 GC 管,纹理、网格、GameObject 这些原生资源走另一套。很多人只盯托管堆,忘了原生侧才是内存大户。
原生侧两个高频事故点。一是 AssetBundle 的 Unload(true) 时机:它会把”正在被引用的材质”连根拔掉,场景里瞬间一片紫。引用计数是标准解法——被加载 +1、被依赖 +1,Unload 减一,归零才真正释放,依赖包的卸载顺序由此决定。二是纹理资源规范:压缩格式(现代项目用 ASTC)、按需开关 mipmap、控制 GameObject 总数。读数时盯 Reserved 和 Used 的差值(Unity 买下还没还的),GfxDriver 即显存占用,细查用 Memory Profiler 包。
托管侧的场景切换是漏点重灾区:切换时主动 GC.Collect() 配合 Resources.UnloadUnusedAssets,把旧场景的残留一次性清干净,比让它在线上攒成事故好得多。Addressables 把引用管理自动化了一部分,但没有消灭泄漏——Addressables.Release 少调一次,引用计数不归零,资源照样赖着不走。上了 Addressables 的项目反而更需要一张”加载/释放配对”的审查清单。
第四层:加载与包体——带宽、StreamingAssets 与省电
这层最不起眼,但线上事故最疼。带宽的核心权衡是图集粒度:不同时出现的资源不打包,单张纹理控制在 1024 以内(重度项目 256);Mipmap 是”内存换带宽”——增 33% 内存,省采样带宽,UI 贴图关掉、3D 贴图保留。
Android 出包有个我踩过两次才记住的坑:StreamingAssets 在 APK 中默认 Store 不压缩,但重打包流水线(加密、渠道包)如果用 apktool 走一遍,无后缀文件会丢掉 noCompress 标记变成 Deflate——AB 体积没变,加载速度断崖式下跌,且现象只在重打包后的渠道包里出现。标准解法:AB 加后缀名 + aaptOptions.noCompress。
物理容易被漏归进 CPU 层,实际上它吃的是固定步进的确定性时间预算,我习惯归到这层一起管:Fixed Timestep 别用默认值硬扛,移动端取 16~60ms 区间内偏大的值、减少每秒物理步进次数;Mesh Collider 与真实刚体是移动端奢侈品,碰撞体尽量用基本形状,最小化碰撞检测对数。每帧物理开销是常量而非变量——它不随画面内容变,所以必须在项目早期就把预算留出来,后期才发现超了,改起来是伤筋动骨的。
帧率与温控是这层的收尾三件套:关 VSync 用 Application.targetFrameRate 限帧、随之调大 Fixed Timestep 减少物理步进次数(取 16~60ms 区间内的大值)、待机 FPS 直接压到 1。省电即控温,控温即防降频,防降频即防”低端机跑半小时后变卡”这类最难排查的线上问题。
四层讲完,回到总纲:性能优化是定位问题,不是勤劳问题。打开 Profiler 看清瓶颈在哪层,算好预算,把规范做成工具卡进流程——这三件事做对,剩下的是体力活。反过来,跳过定位直接优化,最常见的结局是优化了不占瓶颈的层,帧率纹丝不动,还多背了一堆”为了性能”的复杂度,这种负优化我每年都能在接手的项目里见到。